智慧工厂大数据技术 从数据孤岛到智能决策的技术交流
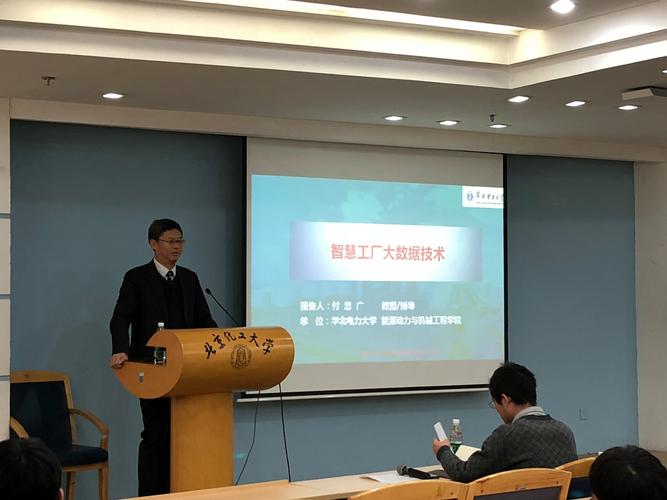
在制造业数字化转型的浪潮中,智慧工厂已不再是遥不可及的概念,而是正在发生的现实。而支撑这一现实的核心引擎之一,便是大数据技术。本次技术交流旨在梳理智慧工厂场景下大数据技术的应用脉络、关键挑战与落地实践,希望能为正在或计划推进智慧工厂建设的同仁提供一些参考。
一、智慧工厂的大数据从哪来?
很多人一谈大数据,首先想到的是互联网的用户行为数据。但在智慧工厂里,数据的来源完全不同,它更“硬”,也更贴近物理世界。主要可以划分为四类:
- 设备与传感器数据:这是智慧工厂大数据的主体。包括PLC(可编程逻辑控制器)采集的时序数据、CNC机床的运行参数、振动传感器、温度传感器、电流电压监测数据等。这类数据的特点是高频、强时序、单条价值低但总量巨大。
- 生产管理系统数据:MES(制造执行系统)、ERP、WMS(仓储管理系统)等产生的工单信息、物料流转、质检记录、人员排班等结构化数据。
- 视觉与图像数据:工业相机在质检、定位、安全监控中产生的图像和视频数据,尤其在缺陷检测场景中价值密度高。
- 环境与能耗数据:温湿度、洁净度、水电气消耗等,用于保障生产环境和实现绿色制造。
这些数据往往分散在不同厂商、不同协议的系统里,形成“数据孤岛”。大数据技术的第一项任务,就是把这些数据有效地汇聚起来。
二、技术栈上的几个关键环节
1. 数据采集与边缘预处理
工厂现场的网络环境和IT环境差异很大,不能简单地把所有原始数据一股脑传到云端。实践中,边缘计算网关承担了关键角色:在设备侧完成协议解析(如Modbus、OPC UA、Profinet等)、数据清洗、降采样和异常剔除,再将有价值的数据上传。
一个常见的坑是:把所有高频振动数据全量上云,结果带宽和存储成本不堪重负,而真正用于故障诊断的特征反而被淹没。因此,边缘侧的特征提取(如计算均方根值、频谱特征)往往比传输原始波形更实用。
2. 数据存储与治理
智慧工厂的数据存储通常采用分层策略:
- 时序数据库(如InfluxDB、TDengine、TimescaleDB)用于存储设备高频时序数据,写入性能和数据压缩是关键指标;
- 关系型数据库承载MES/ERP等业务结构化数据;
- 对象存储用于图像、视频等非结构化数据;
- 数据湖/湖仓一体方案则用于容纳原始数据,支持后续的探索性分析和机器学习训练。
在治理层面,工厂场景下尤其需要建立统一的数据字典和设备模型,否则同一台设备在不同系统中的编码不一致,后续的分析将寸步难行。
3. 计算与分析
批处理(如Spark)适合处理日级的生产报表、OEE(设备综合效率)核算等任务;流处理(如Flink)则用于实时监控产线状态、异常报警。在实际项目中,很多价值场景恰恰是“准实时”的——比如某道工序的工艺参数开始漂移,需要在几分钟内发现并干预,而不是等到班次结束。
4. 数据应用与智能决策
这是大数据技术最终产生业务价值的地方。典型的应用方向包括:
- 设备预测性维护:基于振动、温度、电流等时序数据,结合机器学习模型预测轴承磨损、主轴故障等,减少非计划停机;
- 质量根因分析:将质检结果与上游工艺参数关联,定位影响良率的关键因子;
- 能耗优化:分析空压机、空调机组、产线的能耗模式,识别节能空间;
- 排产与调度辅助:结合历史订单和设备状态数据,为APS(高级计划排程)提供更准确的输入。
三、落地中绕不开的几个挑战
1. 数据质量远比算法重要
在工厂里,传感器松动导致的数据漂移、设备停机期间的无效零值、人工录入的错误批次号……这些问题不解决,再先进的模型也无济于事。项目启动前花时间做数据质量摸底,往往比急于上模型更有回报。
2. 工艺知识与数据科学的融合
纯数据驱动的方法在工业场景中局限性明显——样本量有限(故障样本尤其稀缺)、工况多变(换型、环境变化导致数据分布漂移)。成功的预测性维护项目,通常需要工艺工程师深度参与特征工程和模型验证,把“人”的经验沉淀为“模型”的先验知识。
3. 基础设施与安全的平衡
工厂OT网络与IT网络的融合带来便利,也带来安全风险。在数据采集链路上,应遵循最小权限原则,做好网络隔离,避免因数据集成而打开攻击面。
4. 投入产出的阶段性
智慧工厂大数据项目很难一步到位。比较务实的路径是:先做试点场景(如单条产线的OEE提升或某关键设备的预测性维护),用可量化的效果争取后续资源,再逐步扩展数据底座和数据治理能力。
四、一点
智慧工厂的大数据技术,本质上是架在物理生产线与数字决策之间的桥梁。它不炫技,但要求扎实:采集要可靠,存储要经济,分析要结合工艺,应用要落到降本增效上。希望本次交流中的经验与教训,能为各位在项目选型、架构设计和落地推进中提供一些借鉴。技术方案因厂而异,但“用数据解决真问题”的出发点,是共通的。
如若转载,请注明出处:http://www.hvuuh.com/product/101.html
更新时间:2026-11-21 16:34:13